缘由:拆库这事,是被硬盘逼出来的
我们核心业务用的是垂直分库,100 多个库,散在十几台物理机上。
这套架构跑了有些年头了。一开始挺均衡,每台机器扛几个库,压力分散,磁盘也够用。但时间一长,问题就来了:业务增长是不均匀的。
有的库几年不涨,有的库疯涨。
其中两个库,硬生生吃掉了它所在那台服务器近一半的磁盘空间。硬盘告警从黄色变成红色,再不管就要满了。
先想过扩容。可这台机器是 RAID 卡做的阵列,加盘不是插上去就完事,得做 RAID 扩容重建——耗时是小事,风险才是大事。约等于没得选。
最直接的办法:把这个"巨无霸"库拆出来,单独部署到一台独立服务器上。
说干就干。
然后我就踩进了这次迁移里最深的一个坑。
确定方案:单库导出 + 主从同步
拆一个库出来,思路不复杂:
- 从现有从库把这个库单独导出来
- 传到新服务器,导入
- 新服务器挂到原主库下面,做从库,实时追数据
- 数据追平后,业务切到新服务器
关键是导出的时候要带上 GTID 信息,这样新服务器导入后能自动知道从哪个事务开始继续同步,不用手动找 binlog 文件名和 position。
实施:mysqldump 单库导出 + GTID 同步
第一步:从数据一致的从库导出单库
选一台从库,用 mysqldump 导出目标库。关键参数:
--single-transaction:InnoDB 一致性快照,不锁表--master-data=2:在 dump 文件里以注释形式记录 binlog 文件名和 position(GTID 模式下定位不靠它,留着算个兜底)--set-gtid-purged=ON:把 GTID 集合写进 dump 文件,新库导入后自动知道从哪里开始同步--databases 库名:只导出这一个库
Bashmysqldump -h从库IP -P3306 -u导出账号 -p密码 \
  --single-transaction \
  --master-data=2 \
  --set-gtid-purged=ON \
  --databases 目标库名 \
  > 目标库名.sql
注意:
--set-gtid-purged=ON会在 dump 文件开头写入SET @@GLOBAL.gtid_purged=...。如果新服务器已经有其他库的 GTID 事务,需要先确认是否冲突,必要时改用--set-gtid-purged=COMMENTED,导入后手动处理。
第二步:传输到新服务器
这里直接使用 NFS 存储,省去了传输文件的时间。
第三步:新服务器导入
Bashmysql -u root -p < /data/backup/目标库名.sql
导入完成后,新服务器上这个库的数据就跟导出时刻的从库一致了,GTID 集合也已经写入。
第四步:新服务器配置 my.cnf
ini[mysqld]
server-id=xxx              # 全局唯一,不能跟主库和其他从库重复
relay-log=relay-bin
log_slave_updates=1        # 必须开,否则后续再挂从库会有问题
read_only=1
gtid_mode=ON
enforce_gtid_consistency=ON
重启 MySQL。
第五步:建立主从复制(GTID 方式)
登录新服务器 MySQL:
SQLCHANGE MASTER TO
  MASTER_HOST='原主库IP',
  MASTER_PORT=3306,
  MASTER_USER='复制账号',
  MASTER_PASSWORD='复制密码',
  MASTER_AUTO_POSITION=1;

START SLAVE;
MASTER_AUTO_POSITION=1 是 GTID 复制的关键:新库根据自己已有的 GTID 集合,自动向主库请求缺失的事务,不需要手动指定 binlog 文件名和 position。
第六步:验证同步状态
SQLSHOW SLAVE STATUS\G
确认:
Slave_IO_Running: YesSlave_SQL_Running: YesSeconds_Behind_Master: 0Retrieved_Gtid_Set和Executed_Gtid_Set持续增长直到追平
追平之后,新服务器就是原主库的一个从库了,数据实时同步。
到这里,迁移实施完成。接下来是校验。
校验:pt-table-checksum 踩坑实录
新从库搭好了,数据追平了。但切换之前,必须确认一件事:新从库的数据跟主库真的一致吗?
不能只看 Seconds_Behind_Master: 0 就放心。那个值只代表延迟,不代表数据一致。
数据量是 TB 级,不能用 CHECKSUM TABLE 全表扫——那玩意儿一张大表扫完,磁盘 IO 直接打满,业务跟着抖。也不能全库 mysqldump 导出再 diff,导出十几个小时,占几倍磁盘。
| 之前想过的方案 | 为什么不行 |
|---|---|
CHECKSUM TABLE 全表扫 | TB 级表一次性扫完,IO 打满,业务抖动 |
mysqldump 全库导出 diff | 导出十几小时,占几倍磁盘,线上停不起 |
SELECT COUNT(*) 对比 | 行数一样不代表内容一样,但能先粗筛 |
| 自己写脚本分片算 CRC | 写了一版,主键稀疏的表直接卡死 |
最后选了工业标准方案:pt-table-checksum。
这工具原理不复杂:连主库,按主键把大表切成一小块一小块,每块算个 CRC 写进一张 checksums 表;这张表跟着 binlog 同步到从库,工具再连上从库用同样的分片重新算一遍,两边一对,不一样就是不一致。
不过有个前提,比参数本身更麻烦:这个工具天生不喜欢带复制过滤器的环境。
官方文档写得很直白——它会主动检查从库上的复制过滤规则(replicate_do_db、binlog_ignore_db 这类),一旦发现就直接报错拒绝运行,除非加上 --no-check-replication-filters 强行压过去。理由也很清楚:工具要往 percona.checksums 里写校验结果,这些语句一旦被过滤器拦下,要么复制报错,要么静默写不进去——工具等不到回音,就只能一直等。
官方甚至在文档里明说,不推荐在有复制过滤器的架构上用这个工具。
而我为了不让它的校验数据"污染"现有主从,偏偏给它加了一条过滤规则。
它对业务 IO 的保护其实做得挺足:负载超过 --max-load 的阈值会自己暂停,每个 chunk 的目标耗时由 --chunk-time 控制(默认 0.5 秒),等从库追上来的间隙由 --check-interval 决定。该削的峰,它自己会削。
听起来简单。实际跑起来,麻烦比参数多。
抄来的参数,得先自己验一遍
第一条命令是照着网上的"最佳实践"拼的,多行折叠,每行末尾一个反斜杠。
跑起来报 More than one host specified——工具认为我给了多个主机地址。
查了半天,问题在那个反斜杠上:末尾不小心多敲了一个空格,bash 就把空格后面的内容当成了独立参数。这种错肉眼几乎看不出来,代价是十分钟。
后来又在 --set-vars 上绕了一次。想让工具用 utf8 连库,顺手写了 --set-vars charset=utf8,报 Unknown system variable 'charset'。
MySQL 里根本没有叫 charset 的系统变量,正确的名字是 character_set_client。charset 是 DSN 里的写法,和 --set-vars 不是一回事——两个地方长得像,语义完全不同。
客户端连不上,不一定是数据库的问题
txtCan't initialize character set utf8mb4
看到这个报错,第一反应是库的字符集出了毛病。其实不是——库确实是 utf8mb4,是跑工具那台机器上自带的 MySQL 客户端字符集文件不全,连不上而已。
在连接参数里指定 charset=utf8,就绕过去了。
这里有个细节值得说清楚:客户端连接字符集不影响服务端的 CRC 计算。 哈希是在 MySQL 进程内部算的,用的是表本身的字符集,所以用 utf8 去连一个 utf8mb4 的库,校验结果依然可信。
但这个"可信"有个前提:主从两边表的字符集和 collation 必须一致。 如果一边是 utf8mb4_general_ci、另一边是 utf8mb4_0900_as_cs,同样的数据算出来的 CRC 天然就不一样——而工具不会提示你这一点,它只会报"数据不一致",让你去查半天。
它要的是一整组授权,少一个都卡
这个工具对权限的要求比预想的高,而且是一路卡、一路补。
先是 SUPER:
txtThis tool requires binlog_format=STATEMENT, but the current binlog_format is set to ROW
线上是 ROW 模式复制,但 pt-table-checksum 要求 statement 格式——它的校验语句得靠 statement 复制才能原样传到从库上重放,所以工具会在主库上把 binlog_format 设成 STATEMENT。这不是某个老版本的遗留问题,是所有版本的固定行为。
加 --no-check-binlog-format 没有用,这个参数只是跳过前置检查,阻止不了工具内部执行 SET 语句。最后还是给校验账号临时加了 SUPER,跑完再回收。
接着是自动发现从库要的 PROCESS:
txtYou do not have the PROCESS privilege
用 --recursion-method=processlist 时,工具要靠 SHOW PROCESSLIST 找到从库那条 Binlog Dump 连接来完成自动发现,没有 PROCESS 权限,这步就做不了。
再往后是建库的权限:
txtAccess denied for user to database 'percona'
--create-replicate-table 会自动去建 percona 库,账号没有 CREATE DATABASE 自然失败。手动把库先建好,再跑就行。
最后是那个最磨人的——每一张表跑完都报一次:
txtUPDATE command denied to user for table 'checksums'
工具往 percona.checksums 写校验结果时,除了写入,还要回填主库侧的 CRC 值,所以 UPDATE 权限同样不能少。账号只给了 INSERT,于是日志刷了一屏又一屏,全是同一个错。
把 UPDATE 权限补齐,世界才清净。
最后卡住的那一屏
权限补完,命令终于跑起来了。主库这边分片计算、写入 checksums 表,一切顺利。
然后它就停在了这里:
txtWaiting to check replicas for differences:   0% 00:00 remain
Waiting to check replicas for differences:   0% 00:00 remain
Waiting to check replicas for differences:   0% 00:00 remain
一直刷,一直 0%,一直不动。
这里有两个可能:
一是 processlist 模式自动探测从库失败了。工具找不到从库,就没法去从库上对比 CRC,只能干等。
二是更隐蔽的那个——从库上的复制过滤规则,把校验语句静默拦掉了。 工具往 percona.checksums 写结果的那条语句,一旦被过滤器判定为"不该执行",从库这边不报错、不写入,主库那边就永远等不到回音。工具不会告诉你"我这儿被拦了",它只会继续等。
Percona 官方博客专门写过这个场景:过滤器跟这个工具撞上时,从库会 skip these statements with no errors, and simply not write into percona.checksums——没有报错,就是不写。 然后工具就一直刷那行 Waiting。
尝试了 DSN 静态指定从库的方式,在这套环境下还是没完全跑通。
折腾了一大圈,pt-table-checksum 最终放弃。
不过这次踩坑真正的起点,不在 pt 身上,而是我在动它之前加的那行配置。
我的顾虑很实际:pt 会往 percona 库里写校验数据,这些数据跟业务没关系,没必要同步到从库;万一再搅进现有主从关系里,更麻烦。所以我加了一条复制过滤规则,把 percona 库排除在外——先把自己摘干净。
动机没问题。写法出了问题。更糟的是,pt 都放弃了,这行配置我却没撤,它就那么留在文件里,安静地过滤着后面所有业务库的变更。
改用脚本:最朴素的办法
工具靠不住,就回到最朴素的办法。
写了个脚本,逻辑很简单:
- 分别连主库和从库
- 拉取所有库、所有表的清单
- 逐表执行
SELECT COUNT(*) - 对比主从行数,输出差异
不精确,行数一样不代表内容一样。但能定位缺表、能定位明显的数据缺失,这就够了。
脚本跑了一段时间,结果出来了。
新从库上缺了多张表。大量表的行数对不上。
有的表,主库这边一直在写,从库那头却停在了某一刻。不是差几行,是整段整段地没有。
更关键的是:主库新建的表,从库上根本不存在。
但 show slave status 显示一切正常。Slave_IO_Running: Yes,Slave_SQL_Running: Yes,Seconds_Behind_Master: 0。
主从状态正常,数据却丢了。
根因:一行配置写反了
对比了两台从库的配置。
一台从库,一切正常,脚本 count 没有差异。
新搭的这台从库,my.cnf 里有这么一行:
inireplicate-wild-do-table=percona.%
这行就是前面提到的那条规则——怕 pt 的校验数据污染从库,特意加上去挡它的。
但 replicate-wild-do-table 是白名单,不是黑名单。
写了这一行,意思是:只有匹配 percona.% 的 binlog 事件才在从库执行,其余全部丢弃。
不是"忽略 percona 库",是"只复制 percona 库"。
业务库的 DDL、DML 全被过滤了。主库新建表,从库不建;主库写入数据,从库不写。但 SQL 线程没有报错——它只是把不匹配的事件丢掉了,show slave status 依然显示一切正常。
这才是最可怕的:同步状态正常,不代表数据一致。
想忽略 percona 库,正确的写法应该是:
inireplicate-wild-ignore-table=percona.%
ignore 是黑名单,匹配到的跳过,其余全部执行。一个 do,一个 ignore,意思完全相反。
惊险的地方:还没切换
发现这个问题的时候,新从库刚搭好,正在测试阶段,跑了几天。
也就是说,数据只丢了几天。
这个时候还没有做业务切换。
想象一下,如果没做测试、没跑 count 脚本,直接切了——切过去的是一份缺表缺数据的从库,业务一跑,各种查不到数据、各种报错,那才叫真正的事故。
时间紧,测试只跑了几天。但就是这几天,把这个雷排掉了。
测试这东西,跑了不一定发现问题,但不跑一定发现不了。
修复
把 replicate-wild-do-table=percona.% 注释掉,换成 replicate-wild-ignore-table=percona.%,重启从库。
但改完配置不会自动把丢失的数据追回来。过滤期间主库所有的变更,从库都没执行。
重新做了全量备份,重新导入,重新建立主从复制,追平数据。
再跑一遍 count 脚本,全部一致。
切换:把新库扶正
配置改回来、数据重新追平、count 脚本也全绿了——到这一步,才轮到真正的切换。
切换的动作全部在新库上做:
SQLSTOP SLAVE;

-- 清掉 master.info 中的明文密码与连接信息
RESET SLAVE ALL;

-- 期望 Empty set(复制配置已清)
SHOW SLAVE STATUS\G

-- 解开只读
SET GLOBAL read_only = 0;
SET GLOBAL super_read_only = 0;

-- 建立新的 binlog 基线
FLUSH LOGS;

-- 记录当前 File / Position / Executed_Gtid_Set
SHOW MASTER STATUS\G
几个值得说明的地方:
RESET SLAVE ALL不只是停复制,它会顺手把master.info里存的明文主库密码一起抹掉(master_info_repository默认是FILE,密码就在这个文件里;如果配成了TABLE,密码存在mysql.slave_master_info表,一样会被清)。旧主库的连接信息留在新库上本身就是隐患,这一下正好清了。- 只读要解两层:
read_only和super_read_only都得关,少关一个,业务的写进来照样报错。 FLUSH LOGS是为了把 binlog 轮转到一个新文件,拿一个干净的起点,新的 File 和 Position 从这里开始算。Executed_Gtid_Set不受它影响——那个值取决于这个实例执行过哪些事务,跟轮不轮转 binlog 无关。三个值一起存档,以后再有别的从库挂到这台新主库上,靠的就是它们。
配置文件这边还有三处要从"从库模式"里退出来:
ini# 需要注释
replicate_do_db
read-only
slave_skip_errors
这些是它当从库时的配置,现在它要对外提供写服务了,留着只会添乱。
全部确认无误,再把业务连接切过来。
全流程回顾:一张图看完整个迁移
故事讲完了,把整个过程捋成一张图,看得更清楚些:
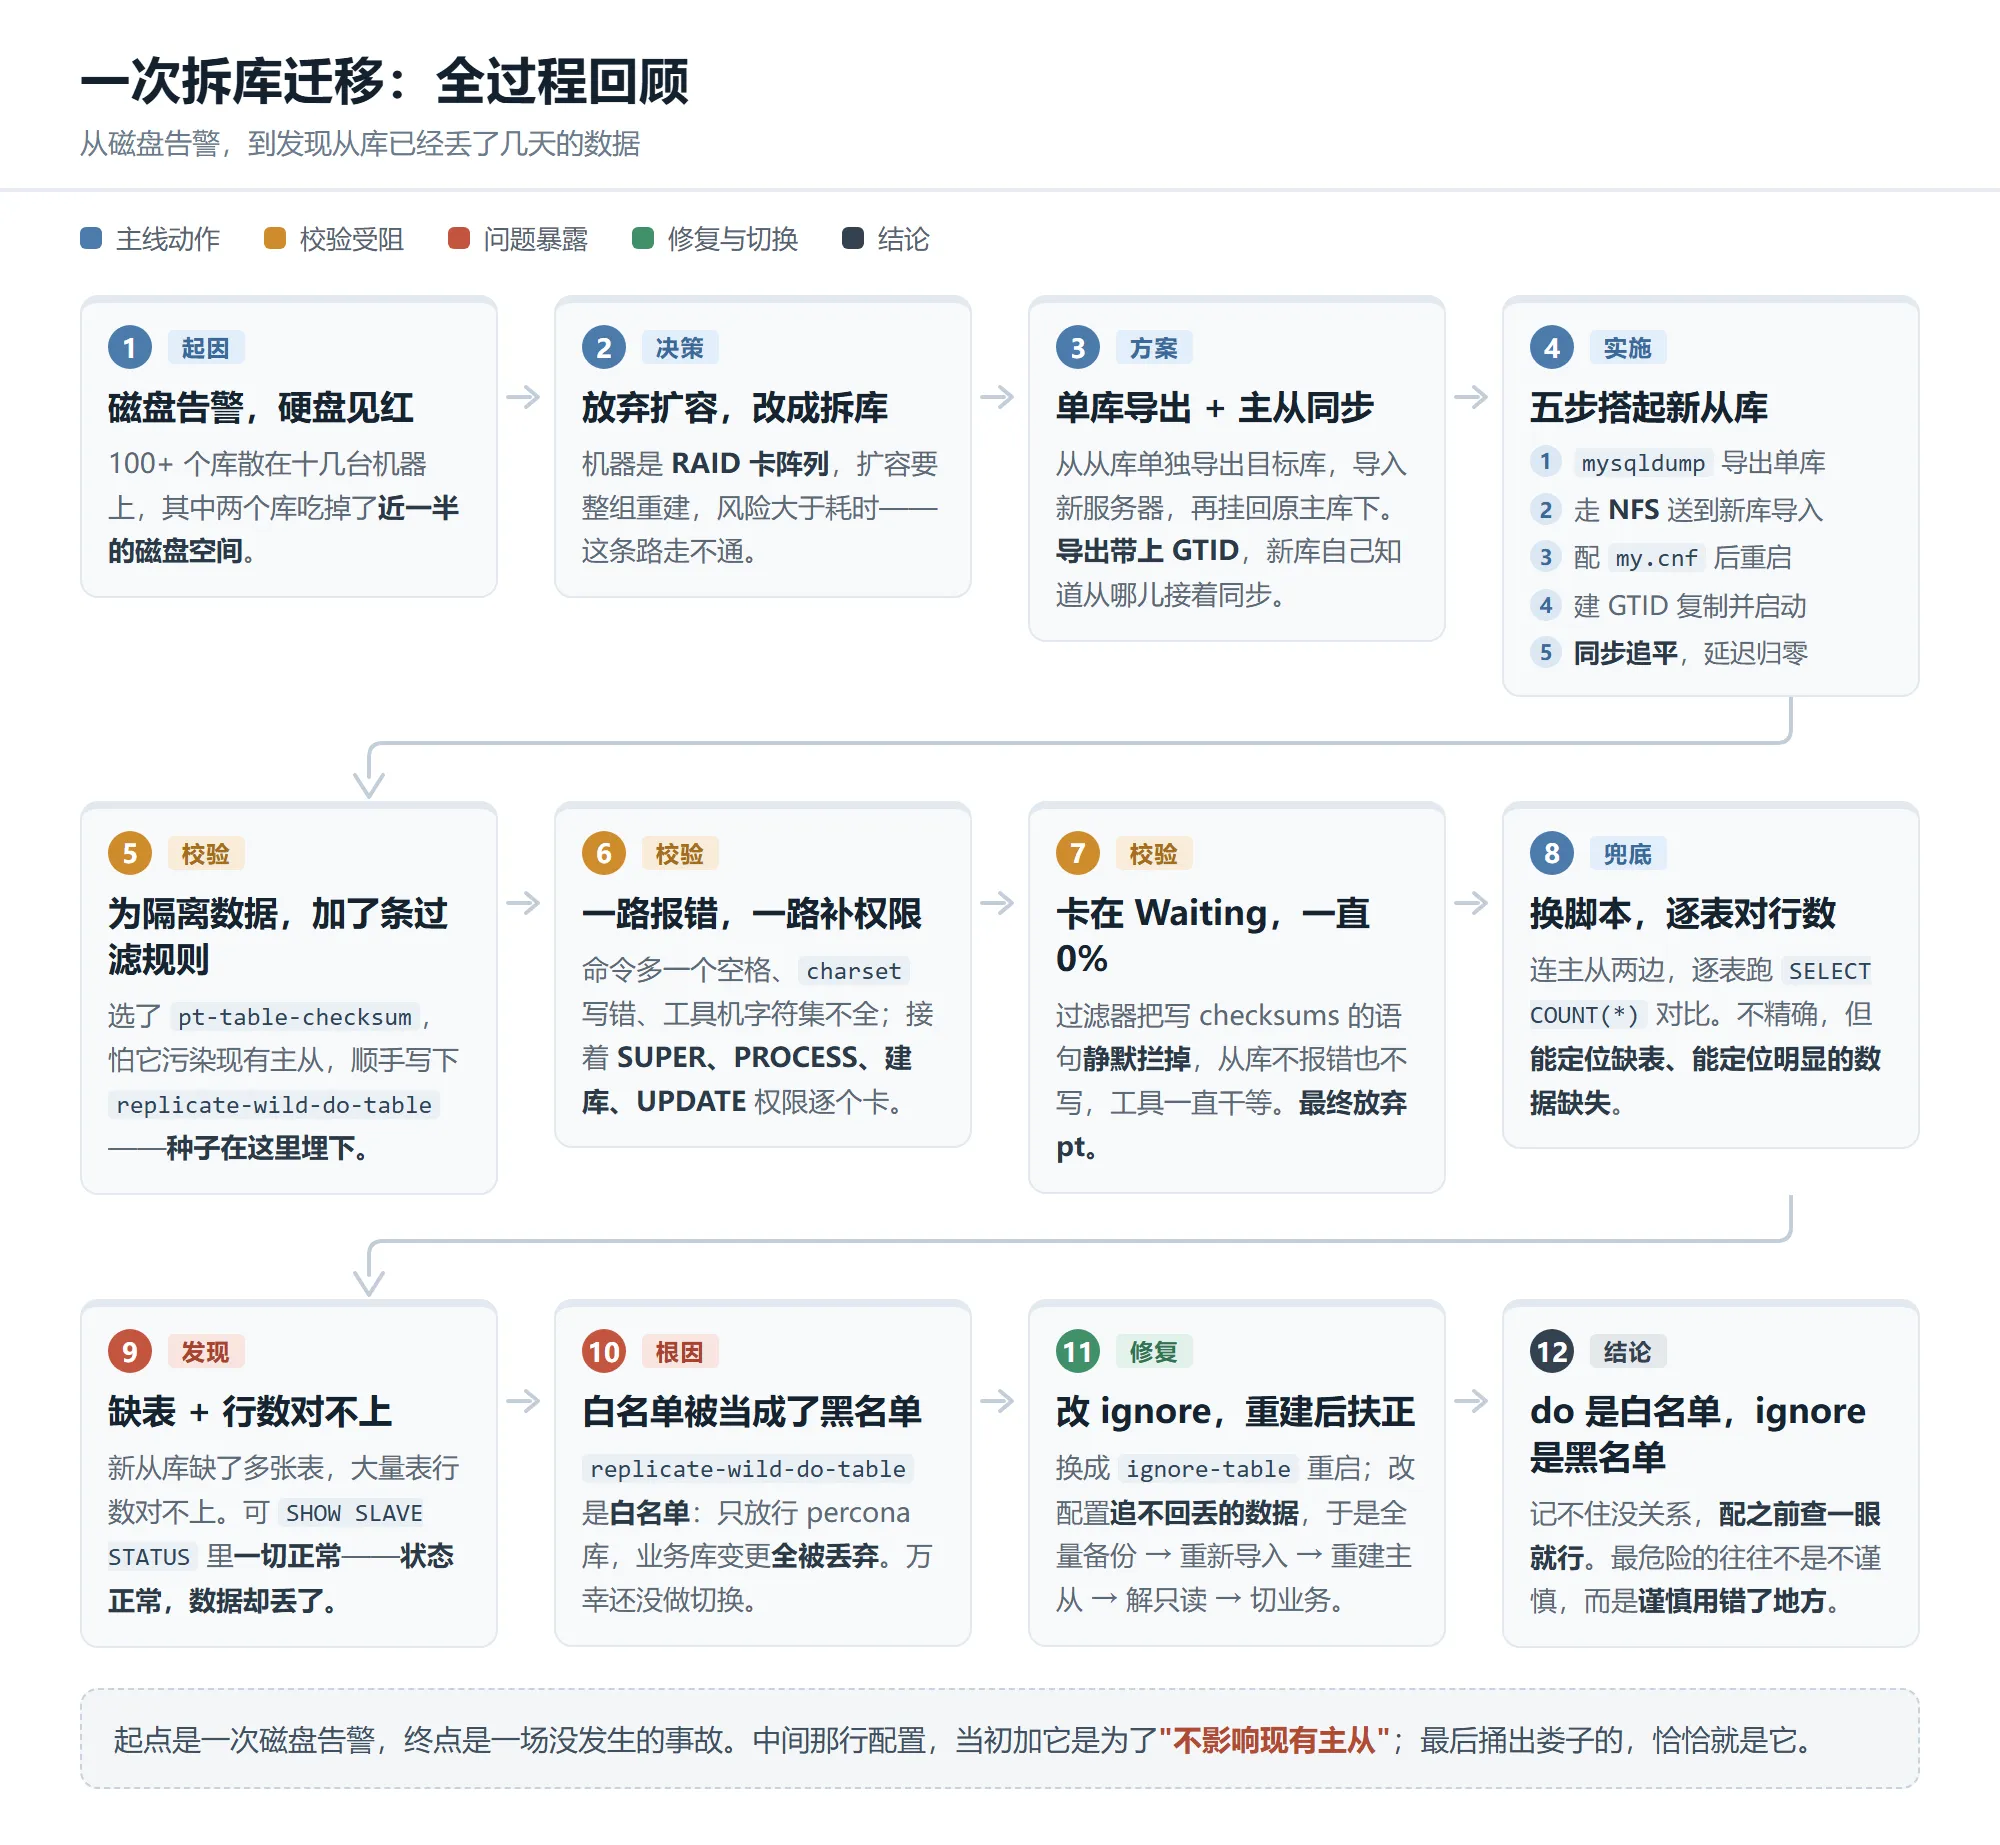
蓝色是主线动作,橙色是校验受阻的那段弯路,红色是问题暴露,绿色是修复和切换。从磁盘告警到最后扶正,中间那条弯路,一步都没少走。
泼个冷水
老实说说这次复盘里,还没做到位的地方:
- 复制过滤规则没有纳入变更评审。 当初加
replicate-wild-do-table的时候,没有仔细确认 do 和 ignore 的区别,也没有在测试环境验证。一行配置,埋了几天的雷。 现在加了一条规矩:任何复制过滤参数的变更,必须在从库上用测试表验证过才能上线。 - 主从一致性核对没有常态化。 这次是因为要迁移才主动查的,如果一直不查,这个问题可能还会藏更久。现在定了每月跑一次 count 脚本,出差异自动告警。
- count 脚本只能查行数,查不了内容。 行数一致但字段值被改了,这种问题 count 发现不了。后续还是得把 pt-table-checksum 跑通,或者找其他 CRC 校验方案,做更精确的核对。
- 工具版本管理粗放。 apt 源的 percona-toolkit 版本老旧,坑多。生产环境应该用官方源装新版,或者至少锁定一个经过验证的版本。
- 垂直分库的增长不均是必然。 100+ 库分散在 10+ 台机器,迟早会出现"一台机器被一个库撑爆"的情况。这次是硬盘告警了才动手,下次应该提前监控各库增长趋势,在告警之前就规划拆分。
- 测试时间还是太短。 这次只测了几天,运气好发现了问题。如果数据丢失是更隐蔽的形式(比如行数一致但内容不对),count 脚本可能发现不了。后续迁移应该预留更充分的测试窗口,不能因为时间紧就省掉验证环节。
写在最后
这次迁移,最大的教训不是 pt-table-checksum 有多少参数要调,而是:
do 是白名单,ignore 是黑名单。记不住没关系,配之前查一眼就行。我这次,就是没查。
主从显示正常,只能说明 IO 线程和 SQL 线程没报错。SQL 线程把事件悄悄丢掉的时候,它不会告诉你。
一行配置写反,主从替你安静地丢了几天数据。它不报错,不告警。你不去 count,就永远不会知道——有的表少了一截数据,有的表,从库上根本没有。
好在,还没切换。
后来配置改回来、数据重新追平、校验再跑一遍全绿,这台新库才被正式扶正——切换的每一步都写在前面那节里,一条都没省。
现在再看那行配置:当初加它,是为了"不影响现有主从"。最后捅出娄子的,恰恰就是它。
运维里最危险的,往往不是不谨慎,而是谨慎用错了地方。